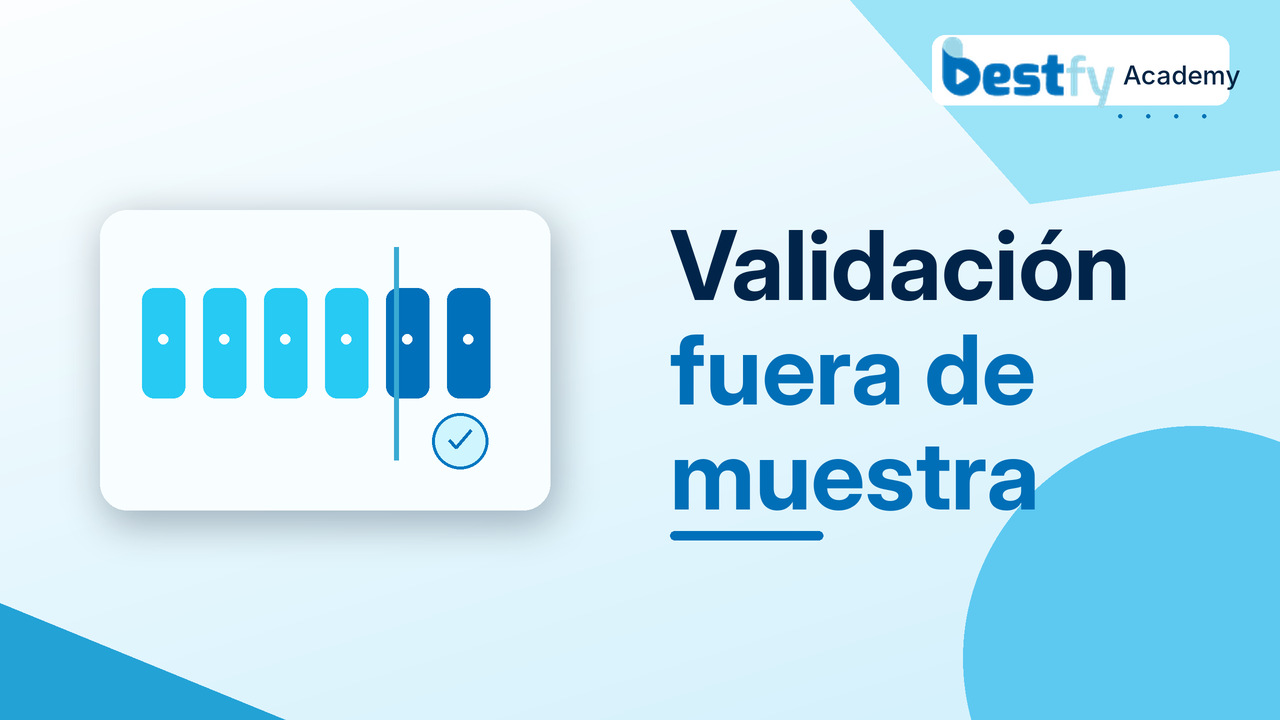
La validación fuera de muestra consiste en evaluar un método con datos que no se utilizaron para ajustar sus parámetros ni, cuando se trata de una prueba final, para elegir entre variantes. Permite investigar su capacidad de generalización; no demuestra por sí sola que vaya a funcionar siempre.
Por qué es imprescindible reservar casos nuevos
Un modelo puede aprender las relaciones y también las rarezas de los partidos que ha visto. Si se le examina con esos mismos partidos, se le permite responder sobre un material conocido. La validación fuera de muestra crea una frontera entre construir el modelo y evaluarlo sobre encuentros no utilizados en esa construcción.
Es frecuente distinguir tres funciones. En entrenamiento se calculan coeficientes y transformaciones. En validación se comparan alternativas y se decide cuál conservar; aunque sus datos no se utilicen directamente para cada ajuste, la elección introduce información de ese bloque. En prueba final se evalúa una versión cerrada, sin usar previamente esos resultados para desarrollar, seleccionar o corregir el sistema. Una nueva modificación después de examinar la prueba hace que esos casos dejen de ser completamente independientes para nuevas evaluaciones.
En deportes, una separación aleatoria de encuentros puede resultar engañosa: puede mezclar el futuro con el pasado, compartir datos derivados o relacionar registros de una misma jornada. Lo apropiado suele ser fijar cortes temporales y replicar el instante de disponibilidad de cada variable. La documentación de herramientas como TimeSeriesSplit explica un procedimiento, pero no elimina por sí sola la irregularidad del calendario futbolístico: hay que definir ventanas y grupos adecuados.
Ejemplo resuelto: tres tramos de una liga inventada
Ejemplo ficticio de fútbol. Disponemos de 120 registros ordenados cronológicamente, que no corresponden a una liga real. Reservamos los primeros 70 para entrenar, los 20 siguientes para escoger entre dos versiones y los últimos 30 para la evaluación final. El objetivo común es predecir si ganará el equipo local; todas las predicciones finales se emitirían con la información disponible antes de cada encuentro.
Paso 1: en los 70 primeros, se ajustan variables de forma y localía, estadísticas normalizadas y coeficientes del modelo. Paso 2: en los 20 siguientes se decide qué versión usar, sin incorporar información posterior a la fecha de cada predicción. Paso 3: se congela la versión seleccionada y se evalúan los 30 últimos, completamente reservados hasta ese momento.
Supongamos que el modelo final acierta 19 de 30 etiquetas de victoria local y una referencia sencilla acierta 18 de 30. Eso equivale a 63,33 % frente a 60 %. La diferencia son un acierto y 3,33 puntos porcentuales en esa pequeña prueba. No sería riguroso declarar una ventaja general ni una futura rentabilidad: faltan tamaño de muestra, incertidumbre, calidad de probabilidades, cuotas comparables y replicación en otros periodos.
Si usamos los últimos 30 para experimentar con cinco valores de un parámetro y elegimos el que mejor resultado arroja, ya hemos convertido ese tramo en validación para selección. Para medir el rendimiento final habría que reservar otros datos posteriores.
Validar con rigor no es solo dividir la tabla
Los registros pueden incluir partidos aplazados, correcciones publicadas después, múltiples cuotas del mismo encuentro y ligas con comportamientos diferentes. Se debe preservar qué partidos eran candidatos, sus horas, el mercado, las fuentes y las exclusiones. Una separación cronológica por filas no garantiza comparabilidad temporal si los encuentros están irregularmente espaciados. También hay que impedir que dos registros del mismo partido contaminen bloques diferentes.
Cuando se reentrena a lo largo del tiempo pueden usarse varias ventanas sucesivas de evaluación, siempre respetando el orden: entrenar con el pasado, pronosticar el bloque siguiente y avanzar. Esa técnica permite estudiar estabilidad temporal, pero debe documentarse si las métricas de cada ventana son comparables y qué reglas de selección se aplicaron. El resultado no es una garantía; mercados, reglas y poblaciones cambian.
- Error: llamar fuera de muestra a datos empleados repetidamente para escoger hiperparámetros.
- Error: usar variables cuya disponibilidad real es posterior a la predicción.
- Error: interpretar una pequeña superioridad puntual como prueba de ingresos futuros.
Qué recordar: reservar datos posteriores sirve para poner a prueba una explicación que todavía no ha visto esas respuestas. Es una condición de rigor, no una certificación de éxito.
Conceptos relacionados
- Backtesting
- Sobreajuste
- Fuga de información
- Brier score
- Tamaño y selección de la muestra