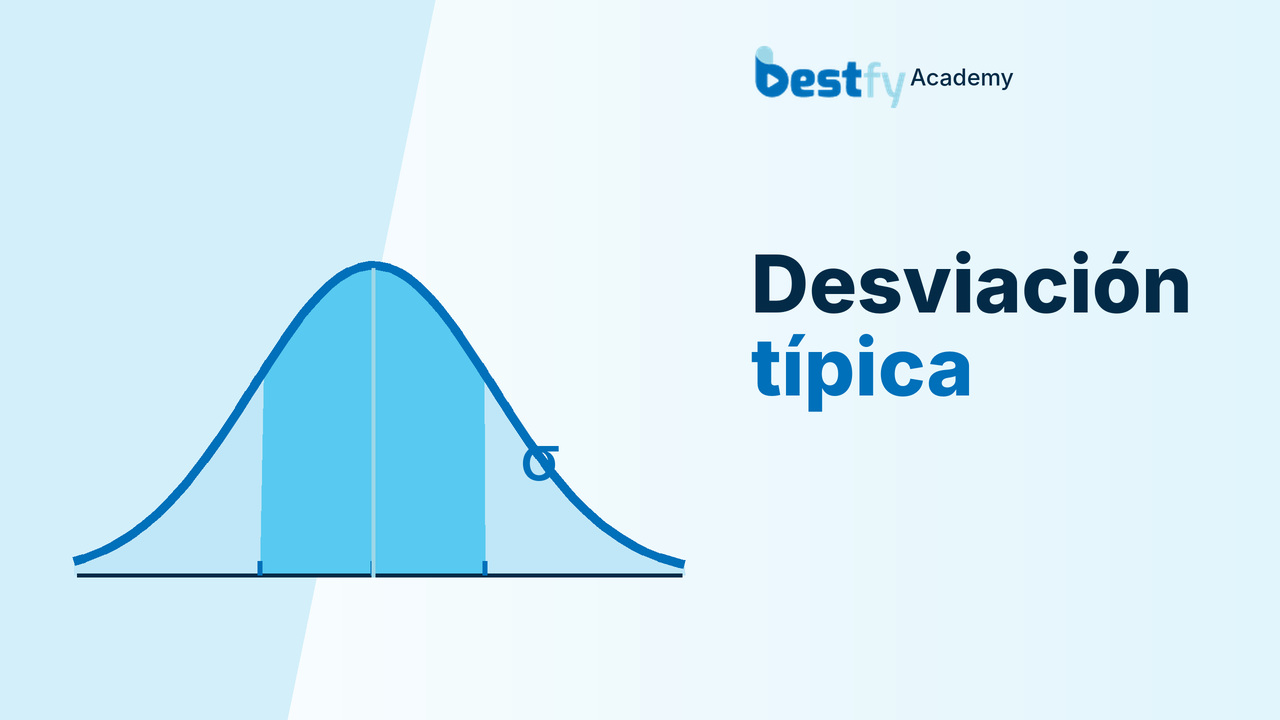
La desviación típica, o desviación estándar, es la raíz cuadrada de la varianza. Describe la dispersión de una variable usando las mismas unidades que sus valores originales, lo que permite interpretar mejor la amplitud habitual de los resultados bajo un conjunto de datos o un modelo especificado.
Por qué sacar la raíz cuadrada
En la ficha de varianza, las distancias al promedio se elevan al cuadrado. Eso evita que se anulen las desviaciones positivas y negativas, pero crea una unidad poco natural: si los resultados son unidades de simulación, la varianza se expresa en unidades cuadradas. La desviación típica resuelve este inconveniente tomando la raíz cuadrada de aquella cifra.
Una desviación típica grande indica que los valores están relativamente dispersos en la escala elegida; una pequeña, que se concentran más alrededor de la media. La comparación solo es clara si hablamos de la misma variable y de una unidad compatible. No tiene el mismo significado una desviación típica de goles por partido que otra de beneficio neto por posición.
Se suele utilizar σ para la desviación de una distribución teórica y s para la desviación estándar muestral. La distinción importa porque también cambia la fórmula de varianza de la que se toma la raíz: si se describe un registro completo, el denominador es n; si se estima la varianza poblacional con la convención muestral habitual, se usa n − 1.
Ejemplo ficticio: dos secuencias con igual media
Consideremos dos registros simulados de cuatro partidos ficticios cada uno. Se ha calculado el resultado neto en unidades de simulación de una posición hipotética en cada partido; no se asume que los ocho encuentros pertenezcan a una distribución real común.
Registro A: +10, −10, +10, −10. Su media es cero y su varianza descriptiva, dividiendo entre las cuatro observaciones, es 100 unidades². Aplicamos raíz cuadrada: √100 = 10 unidades de desviación típica descriptiva.
Registro B: +5, −5, +5, −5. También tiene media cero. Sus cuatro desviaciones al cuadrado son 25, de modo que la varianza es (25 + 25 + 25 + 25)/4 = 25 unidades² y la desviación típica es √25 = 5 unidades.
Ambos registros promedian exactamente cero, pero A muestra el doble de desviación típica que B en la misma escala. Esto informa de la distribución de los resultados, no de la calidad de las decisiones previas. Si las cuatro observaciones fueran una muestra y usásemos n − 1, las desviaciones típicas serían √(400/3) ≈ 11,55 y √(100/3) ≈ 5,77 unidades, respectivamente. No es apropiado mezclarlas en una comparación sin declarar la fórmula.
La dispersión de éxitos no equivale a una garantía
La desviación típica también aparece en modelos de recuentos. Supongamos, solo para entender una fórmula, 100 ensayos independientes con probabilidad fija de éxito del 50 %. El número de éxitos X sigue una binomial en ese modelo: su media es n × p = 100 × 0,50 = 50 y su varianza es n × p × (1 − p) = 25; por tanto, su desviación típica es 5 éxitos.
Eso no obliga a obtener entre 45 y 55 en cada grupo de cien, ni significa que la diferencia absoluta nunca pueda superar cinco. Es una medida de dispersión, no un límite máximo ni un intervalo garantizado. Además, muchos mercados y partidos reales no cumplen independencia y probabilidad constante.
Conviene diferenciar la desviación de resultados individuales de la incertidumbre de una media estimada. Bajo independencia y condiciones adecuadas, promediar más observaciones puede reducir el error de la media aunque la dispersión de un resultado individual permanezca intacta.
Errores frecuentes y recordatorio
- Tomarla como pérdida máxima: pueden aparecer resultados mucho más alejados del promedio.
- Usarla para certificar una estrategia: describe una distribución, no demuestra rentabilidad ni calibración.
- Confundirla con la varianza: la desviación típica lleva unidades originales; la varianza, unidades cuadradas.
Qué debes recordar: la desviación típica convierte una medida de dispersión a una escala legible. Siempre exige decir qué variable se midió, en qué unidades y con qué denominador.
Conceptos relacionados
Varianza; Tamaño y selección de la muestra; Ley de los grandes números; Frecuencia observada; Valor esperado; Distribución binomial.